 Folha Narradora
Perguntas frequentes
A narração por IA soa artificial para crianças?
Os áudios possuem uma marca d’água inaudível que os identifica como síntese. No entanto, vozes como Luna (suave, contação de histórias) e Nova (brilhante, animada) são baseadas em gravações licenciadas, oferecendo naturalidade adequada para narrativas infantis.
Posso misturar TTS com vozes humanas?
Sim. Como a API retorna arquivos de áudio (MP3, WAV, etc.), você pode editar esses arquivos junto com gravações humanas em qualquer software de edição. Não há restrição técnica para combinar fontes diferentes no mesmo projeto.
Qual a diferença de qualidade entre os modelos?
Os modelos tts-1 e tts-1-hd utilizam o mesmo motor de síntese e têm o mesmo preço. A diferença reside apenas no formato de codificação do áudio gerado, sem variação na qualidade vocal ou na entonação da narração.
O TTS substitui completamente o professor?
Não. O TTS é uma ferramenta de narração automatizada. Ele não possui inteligência pedagógica própria, nem interage com o aluno. O professor continua essencial para a mediação, interpretação e adaptação do conteúdo apresentado pelo áudio gerado.
Como garantir a pronúncia correta de nomes próprios?
A API não oferece dicionário de pronúncia personalizado (SSML). Para garantir a pronúncia, o educador deve ajustar a ortografia do texto de entrada (input) até que a síntese produza o som desejado, testando pequenas variações.
O áudio gerado tem direitos autorais?
As vozes são baseadas em gravações licenciadas (LibriTTS-R, CC BY 4.0). Cada arquivo gerado carrega uma marca d’água inaudível que o identifica como fala sintética. O texto original mantém seus próprios direitos autorais sobre a narração.
Posso usar o TTS em plataformas de videoaula?
Sim. A API gera arquivos de áudio (mp3, wav, opus, flac, pcm) que podem ser baixados e inseridos em qualquer plataforma de videoaula. Basta enviar o texto via POST e utilizar o arquivo retornado na edição.
Qual a diferença entre MP3 e WAV no TTS?
A diferença está no formato de arquivo e na compressão. MP3 é comprimido com perda, resultando em arquivos menores. WAV é sem compressão, mantendo a fidelidade original. Ambos utilizam o mesmo motor de síntese e têm o mesmo preço.
O TTS é acessível para deficientes visuais?
Sim, pois gera áudio a partir de texto, permitindo que conteúdo visual seja consumido auditivamente. A API suporta múltiplos idiomas e formatos de áudio, facilitando a integração com leitores de tela e tecnologias assistivas existentes.
Posso baixar os áudios para uso offline?
Sim. A API retorna o arquivo de áudio na resposta da requisição. Você pode armazená-lo localmente ou em servidores próprios para uso offline, sem necessidade de conexão constante para reproduzir o conteúdo já gerado.
O TTS melhora com o tempo de uso?
Não. O modelo é estático e não aprende com o uso individual. O texto digitado não é usado para treinar o modelo. A qualidade da narração permanece constante, baseada nos dados de treinamento originais das vozes.
Existe limite de uso diário na API?
Não há limite diário, apenas de taxa: 60 requisições por minuto por chave. O limite é de 60 req/min após o primeiro top-up (10 req/min antes). O saldo não expira, permitindo uso contínuo conforme a disponibilidade de créditos.
O TTS suporta textos com emojis?
O limite é de 4096 caracteres por requisição. Emojis contam como caracteres. Emojis contam como caracteres no limite de 4096 caracteres. O tratamento específico de emojis depende do motor de síntese.
Como o TTS lida com abreviações?
Não há dicionário de pronúncia personalizado. Abreviações devem ser escritas por extenso no texto de entrada para garantir a leitura correta. Por exemplo, escreva 'metros' em vez de 'm' se a pronúncia automática não for adequada.
Origem do conteúdo vocal
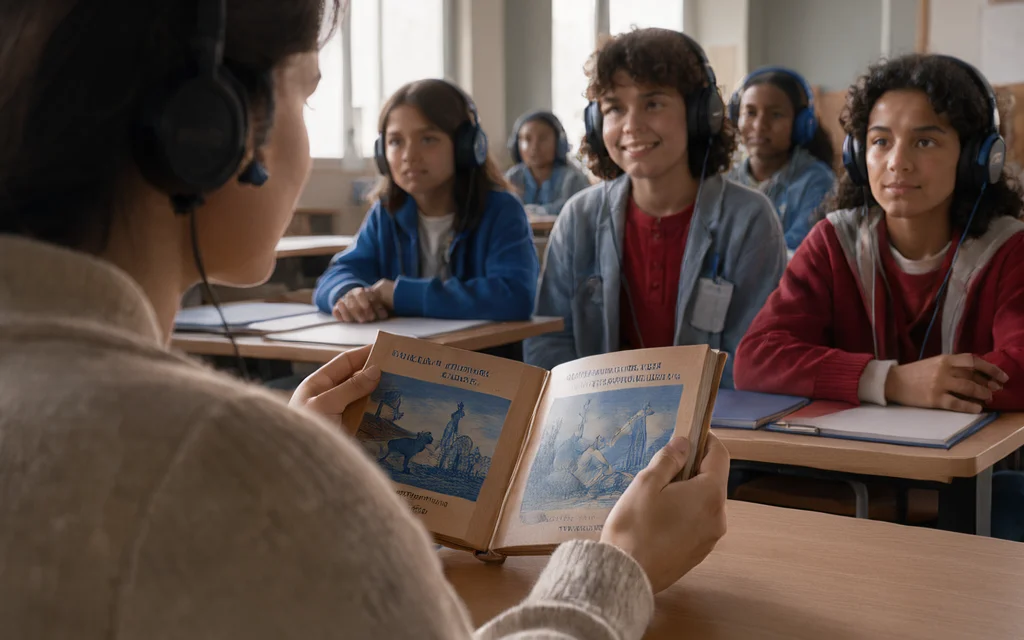
A narração de histórias infantis tradicional depende de gravações humanas, um processo que exige estúdio, tempo e custos fixos elevados. A síntese por IA, como a oferecida pela Folha Narradora, gera áudio via API, permitindo que textos sejam convertidos em arquivos de áudio sob demanda, sem a necessidade de uma equipe de dubladores dedicada.
Gravações humanas vs. síntese de voz
Enquanto a gravação tradicional oferece nuances artísticas únicas, a síntese garante consistência técnica imediata. Não há variações de saúde vocal ou indisponibilidade do narrador. O texto é processado e entregue como arquivo de áudio, mantendo a clareza necessária para o contexto educacional.
Licenciamento de vozes públicas
Nossas vozes são baseadas em gravações licenciadas do LibriTTS-R (CC BY 4.0), originárias de leituras de audiolivros em domínio público do LibriVox. Isso elimina custos de licenciamento recorrente por uso, comum em serviços de narração proprietários, mas o preço da API é baseado no volume de caracteres processados.
Marca d'água de síntese
Todo arquivo gerado carrega uma marca d'água inaudível que identifica o conteúdo como fala sintética. Isso garante transparência na origem do áudio, diferenciando claramente a produção automatizada de gravações humanas em materiais didáticos.
Personalização em tempo real
A API permite ajustar a velocidade de leitura entre 0,25 e 4,0 vezes, permitindo que educadores adaptem o conteúdo para alunos com diferentes velocidades de processamento. Essa flexibilidade é crucial para tornar histórias infantis mais acessíveis sem perder a clareza da narração.
Com oito vozes distintas, cada uma com características específicas, é possível escolher o tom ideal para cada faixa etária. A troca de voz é imediata, facilitando a criação de diálogos ou a manutenção do interesse durante a leitura de contos longos.
Ajuste de velocidade dinâmico
O parâmetro speed na requisição JSON aceita valores de 0,25 a 4,0. Isso permite acelerar a narração para revisões rápidas ou desacelerar para alunos que necessitam de mais tempo para decodificar o texto escrito.
A velocidade afeta a percepção auditiva, mantendo a entonação natural em ajustes moderados, o que é essencial para a compreensão de narrativas estruturadas em sala de aula.
- Configuração via parâmetro numérico simples.
- Intervalo de 0,25x a 4,0x.
- Sem perda de qualidade na voz base.
Escolha de vozes sob demanda
As oito vozes disponíveis, como Aria, Nova ou Atlas, são pré-selecionadas para diferentes tons narrativos. Educadores podem alternar entre vozes masculinas e femininas para representar diferentes personagens ou contextos de uma história.
A seleção é feita diretamente no campo voice da API, sem necessidade de processamento adicional. Cada voz mantém consistência sonora, garantindo que a experiência auditiva não frustre o aluno com variações abruptas de timbre.
- 8 presets disponíveis.
- Opções masculinas e femininas.
- Escolha imediata via API.
Geração instantânea de novos trechos
Ao enviar um texto, o áudio é gerado em poucos segundos para frases curtas. Para textos longos, o tempo de geração aproxima-se do tempo real de audição. Isso permite a criação sob demanda de áudios para leituras do dia seguinte.
Não há necessidade de agendar gravações em estúdio. O educador pode enviar o texto via POST e receber o arquivo de áudio pronto para distribuição, garantindo que o material esteja disponível assim que necessário.
- Geração rápida para frases curtas.
- Processamento sequencial sob carga.
- Disponibilidade imediata após solicitação.
Custo e escalabilidade
A estrutura de preços da API Folha Narradora é baseada estritamente no volume de caracteres processados, cobrando US$ 10 por 1 milhão de caracteres (ou US$ 0,01 por 1.000 caracteres). Espaços e pontuação contam como caracteres, garantindo transparência total no cálculo do custo marginal por caractere.
Custo marginal por caractere
O custo é linear e previsível. Ao enviar textos para síntese, você paga apenas pelo que é processado. Solicitações falhas são totalmente gratuitas, eliminando o risco de desperdício ao testar novos trechos de histórias infantis ou materiais didáticos.
Sem custos de produção fixa
Diferente de estúdios que cobram por sessão de gravação ou por hora de estúdio, aqui não há custos fixos de produção. Não há planos mensais obrigatórios, nem taxas de assinatura ou mínimos de gasto. A conta só aumenta conforme o uso.
Geração ilimitada de cópias (sujeito à taxa de 60 req/min)
Você pode gerar o mesmo áudio quantas vezes precisar, seja para distribuir em tablets ou para backup. A limitação técnica é a taxa de 60 requisições por minuto por chave, o que permite escalabilidade constante sem gargalos de produção em massa.
Acessibilidade e inclusão
A API suporta 23 idiomas, incluindo árabe, chinês e espanhol. Qualquer voz pode falar qualquer um desses idiomas.
A consistência na pronúncia elimina variações humanas, garantindo clareza auditiva para estudantes com dificuldades de leitura ou dislexia, facilitando o acompanhamento textual.
Suporte a múltiplos idiomas
O sistema reconhece automaticamente scripts latinos como inglês, mas permite especificar códigos ISO para precisão. Isso é crucial para manter a integridade fonética em aulas multilingues sem necessidade de múltiplas vozes gravadas.
Adaptação para dificuldades de leitura
A capacidade de ajustar a velocidade entre 0.25 e 4.0 permite personalizar o ritmo de fala. Alunos podem reduzir a velocidade para processar informações complexas ou aumentar para revisões rápidas, mantendo o controle cognitivo.
Uniformidade de pronúncia
Cada voz mantém um padrão consistente entre diferentes sessões de áudio. Isso evita a confusão auditiva causada por variações na entonação humana, oferecendo uma experiência de escuta previsível e didática para o aluno.
Qualidade de áudio
A qualidade do áudio gerado pela API Folha Narradora é definida por clareza e consistência, atributos essenciais para o ambiente educacional. Diferente de gravações humanas que podem variar em tom ou introduzir ruídos ambientais, a síntese de voz oferece uma base limpa e previsível, ideal para o foco na compreensão textual.
Clareza e ausência de ruídos
As vozes pré-estabelecidas, como Aria ou Luna, foram treinadas para manter uma dicção nítida sem interferências de fundo. A ausência de ruídos mecânicos ou variações acidentais de volume garante que a atenção do aluno permaneça no conteúdo narrado, não na qualidade técnica do áudio.
Consistência entre capítulos
Quando se narra uma história longa, a API utiliza os mesmos modelos de voz para todos os trechos. Isso garante que o timbre, o ritmo e a entonação permaneçam uniformes do primeiro ao último capítulo, criando uma experiência auditiva coesa e profissional para coleções de contos.
Formatos digitais otimizados
A API permite a escolha entre formatos como MP3, WAV, Opus, FLAC e PCM. O MP3 é recomendado para economizar banda em dispositivos móveis, enquanto o FLAC oferece qualidade sem perdas para arquivos locais. Essa flexibilidade permite que educadores adaptem o áudio às restrições de hardware de seus alunos.
Controle técnico
O controle técnico é central para educadores que integram narração em plataformas digitais. A API RESTful permite que apps educacionais solicitem áudio sob demanda, substituindo arquivos estáticos por conteúdo gerado dinamicamente conforme o currículo.
Com a base em https://api.st650.info/v1, você pode usar SDKs padrão ou HTTP direto. Isso elimina a necessidade de gerenciar servidores de áudio dedicados para cada história nova.
API para integração em apps
A integração via endpoint POST /v1/audio/speech permite que plataformas de aprendizado enviem textos e recebam arquivos de áudio em segundos. A estrutura JSON é compatível com SDKs conhecidos, facilitando a implementação em ambientes educacionais existentes sem grandes refactorings.
Essa arquitetura permite que o áudio seja gerado apenas quando necessário, reduzindo o armazenamento de bibliotecas de áudio estáticas.
- Endpoint: POST https://api.st650.info/v1/audio/speech
- Formato de corpo: JSON padrão com campo 'input'
- Autenticação via header Bearer
Controle programático de parâmetros
Você define voz, formato e velocidade via JSON. A velocidade ajustável entre 0.25x e 4.0x permite adaptar a narração para crianças em fase de alfabetização ou para revisões mais rápidas.
O formato de saída pode ser escolhido entre mp3, wav, opus, flac ou pcm, garantindo compatibilidade com diferentes players e dispositivos usados em sala de aula.
- Campo 'voice': escolha entre 8 presets
- Campo 'speed': ajuste fino de 0.25 a 4.0
- Campo 'response_format': mp3, wav, opus, flac, pcm
Automação de processos educacionais
Scripts podem automatizar a geração de narrativas para listas de palavras ou exercícios de leitura. Como cada requisição é independente, é possível gerar milhares de variações de texto sem intervenção manual.
O sistema de faturamento por caractere torna a automação previsível em custo, sem picos de geração ou custos fixos de infraestrutura de áudio.
- Geração em lote via scripts
- Custo previsível por caractere
- Sem custos fixos de servidor de áudio
Uso educacional específico
A API de TTS permite ajustar a velocidade de reprodução de 0.25 a 4.0, facilitando a leitura para diferentes faixas etárias. Alunos com dificuldades de decodificação podem ouvir narrativas em velocidade reduzida, enquanto estudantes mais avançados podem acelerar a narração para revisar conteúdos rapidamente sem perder a clareza da voz.
A capacidade de repetir trechos infinitamente apoia o estudo focado. Professores podem gerar arquivos de áudio curtos para exercícios de escuta, permitindo que os alunos revisem passagens específicas até dominarem o conteúdo, algo difícil de replicar em álbuns de áudio pré-gravados.
Adaptação para diferentes idades
O ajuste de velocidade (0.25–4.0) é crucial para adequar o conteúdo à maturidade do aluno. Textos densos podem ser ouvidos mais devagar, enquanto leituras lúdicas podem ser aceleradas.
A escolha de vozes como Luna (suave) ou Felix (energético) ajuda a manter o engajamento de crianças, mantendo a coerência narrativa sem variações emocionais complexas.
- Velocidade ajustável para diferentes níveis de leitura
- Vozes distintas para diferentes gêneros narrativos
Repetição de trechos para estudo
Ao contrário de um livro físico ou arquivo de áudio fixo, o TTS permite regenerar qualquer parte do texto instantaneamente. Isso é ideal para exercícios de repetição e ditado.
O limite de 4096 caracteres por requisição permite criar exercícios segmentados, facilitando a concentração em unidades de aprendizado específicas.
- Regeração imediata de qualquer trecho
- Segmentação natural por limites de caracteres
Geração de material didático sob medida
Professores podem inserir textos personalizados, como listas de vocabulário ou regras gramaticais, e obtê-los em áudio rapidamente. Isso democratiza o acesso a materiais de áudio específicos sem custos de estúdio.
A disponibilidade em 23 idiomas permite criar materiais bilíngues ou de apoio para alunos imigrantes, garantindo pronúncia consistente.
- Conteúdo textual personalizado vira áudio instantaneamente
- Suporte multilíngue para inclusão educacional
Limitações a considerar
Embora as vozes sejam claras e adequadas ao contexto infantil, a síntese não reproduz nuances emocionais complexas. Não há tags de emoção ou variação tonal baseada em sentimento, o que pode limitar a dramatização de contos de fadas mais elaborados.
Ausência de emoções complexas
A API oferece oito vozes pré-definidas com timbres distintos, mas não permite ajustar a intensidade emocional de uma fala específica. Para histórias que exigem grande variação de tom, o educador deve alternar entre as vozes disponíveis ou aceitar a leitura linear.
Sem clonagem de voz personalizada
Diferente de serviços premium, não há opção de clonar a voz do professor ou de um narrador famoso. As vozes são fixas (como Aria ou Luna) e baseadas em gravações licenciadas. Se a identidade vocal for parte crítica da experiência do aluno, esta limitação é relevante.
Dependência de conexão de internet
A geração de áudio ocorre na nuvem via API. Cada solicitação requer conexão estável para receber o arquivo de áudio. Não há versão offline ou armazenamento local nativo da API, o que exige planejamento de acesso em salas de aula com Wi-Fi intermitente.
- Processamento 100% na nuvem
- Sem modo offline nativo
- Requer conexão estável para geração
Direitos autorais
Direitos autorais na narrativa infantil digital exigem clareza sobre a origem dos ativos sonoros. Nossa API utiliza vozes derivadas de gravações licenciadas sob a licença CC BY 4.0, originárias do LibriTTS-R e de leituras do LibriVox. Isso garante que a base vocal é de domínio público ou livremente licenciada, eliminando royalties por uso de voz.
Vozes baseadas em domínio público
As vozes utilizadas são baseadas em gravações do LibriVox, audiobooks em domínio público. A estrutura de licenciamento CC BY 4.0 permite o uso comercial e a modificação, desde que atribuída a origem. Não há riscos de bloqueio por direitos de imagem ou voz de artistas específicos.
- Licença CC BY 4.0 para as vozes base.
- Origem: gravações públicas do LibriVox.
Texto como input único
O texto enviado pelo educador é o único elemento protegido por direitos autorais. A voz sintetizada é um produto técnico, não uma performance artística fixa. O áudio gerado não armazena dados de entrada para treinamento, garantindo que o texto original permaneça sob controle total do professor ou instituição.
- Texto enviado é o único input protegido.
- Dados de entrada não são usados para treinamento.
Uso justo em ambiente educacional
Em contextos educacionais, a conversão de textos em áudio para acessibilidade ou leitura complementa o uso justo. Como a voz não é uma interpretação única e fixa, o risco de violação de direitos autorais é minimizado. O áudio é gerado sob demanda, sem distribuição de arquivos fixos sujeitos a licenças complexas.
Performance técnica
A geração de áudio opera com velocidade aproximadamente igual à da fala real, processando cerca de 25 caracteres por segundo de texto. Para narrativas infantis longas, isso significa que o tempo de produção se alinha à duração da audição, sem atrasos significativos na entrega final do arquivo.
Tempo de geração próximo ao real
O processamento segue uma lógica sequencial onde a produção de áudios longos ocorre em ritmo compatível com o tempo de leitura. Essa característica permite que educadores planejem o uso da API sem grandes descompassos entre a solicitação e o disponibilização do conteúdo sonoro.
- Razão de processamento: ~25 caracteres/segundo
- Ideal para contação de histórias completas
Processamento em fila sob carga
As requisições são processadas uma após a outra. Em momentos de alta demanda, uma solicitação pode aguardar na fila antes de iniciar a síntese, o que deve ser considerado ao gerar múltiplos capítulos simultaneamente para turmas grandes.
Latência para frases curtas
Para trechos breves, o tempo de geração pode exceder a duração do áudio final, levando alguns segundos adicionais. Isso ocorre devido à sobrecarga inicial do serviço, que é perceptível apenas em usos de muito curta duração.
Conclusão prática
O TTS não substitui a experiência imersiva de um audiolivro profissional, mas atua como ferramenta pedagógica robusta. Oferece acesso imediato a narrativas, permitindo que educadores adaptem o conteúdo às necessidades específicas de cada aula sem barreiras de produção.
A combinação de vozes sintéticas com atividades presenciais cria um ecossistema de aprendizagem híbrido. O professor usa a API para gerar materiais personalizados, enquanto mantém o contato humano nas discussões e interpretações mais profundas.
TTS como complemento educacional
A API permite integrar narração em plataformas de ensino existentes, transformando textos estáticos em recursos auditivos dinâmicos. Isso é particularmente útil para alunos que precisam de repetição ou adaptação de velocidade para melhor compreensão.
O custo acessível permite o uso em larga escala, garantindo que todos os alunos tenham acesso ao mesmo material narrado, independentemente do número de estudantes na turma.
- Geração sob demanda de novos trechos
- Adaptação de velocidade para diferentes níveis de leitura
- Custo marginal baixo para materiais de apoio
Combinação com vozes humanas
A voz sintética é consistente e clara, ideal para exercícios de leitura, mas carece da nuance emocional de um narrador humano. O ideal é usar o TTS para exercícios técnicos e vozes humanas para momentos de maior impacto narrativo.
Educadores podem usar a API para criar variações de um mesmo texto, explorando diferentes vozes (como 'luna' para histórias ou 'sage' para instruções) sem precisar gravar múltiplas versões.
Foco na experiência do aluno
A personalização permite que cada aluno ajuste a velocidade da leitura conforme sua capacidade de processamento. Isso reduz a ansiedade de leitura e aumenta a autonomia no estudo.
A disponibilidade imediata de áudio permite que o aluno revisite o conteúdo quantas vezes precisar, consolidando o aprendizado de forma autônoma e contínua.
Quando escolher cada opção
A escolha entre gravação tradicional e TTS depende do fluxo de trabalho pedagógico. A API permite ajustar velocidade e voz sob demanda. Alunos com dificuldades de leitura podem ouvir textos adaptados, embora o processamento seja sequencial e não streaming.
Para livros didáticos interativos
A API permite ajustar velocidade e voz sob demanda. Alunos com dificuldades de leitura podem ouvir textos adaptados, embora o processamento seja sequencial e não streaming.
Para coleções grandes e atualizáveis
Com custo marginal de $0,01 por mil caracteres e sem custos de produção fixa, é ideal para manter bibliotecas vastas. A geração ilimitada de cópias garante consistência entre capítulos sem necessidade de regrabar cada edição atualizada.
Para projetos com orçamento limitado
A ausência de custos de produção fixa e a possibilidade de usar vozes baseadas em domínio público tornam a solução acessível. O top-up via USTRC-20 com mínimo de $5 permite começar com o crédito gratuito de $0,50.
Ouça as 8 vozes
Cada amostra abaixo foi gerada por esta API a partir da mesma frase. A pronúncia é consistente, pois a voz não muda de sotaque dependendo do idioma.


23 idiomas
Qualquer voz fala qualquer um desses idiomas.
Fontes e leituras adicionais
- Wikipedia
- LibriTTS-R paper (arXiv 2305.18802)
- TRON developer hub: TRC-20
- W3C WAI: making audio and video accessible
- IETF RFC 7845: Ogg Opus
- openai-python on GitHub
- FFmpeg documentation
- Python documentation
- ISO 639 language codes
- LibriVox public-domain audiobooks
- MDN: Web Speech API
- LibriTTS-R corpus (OpenSLR 141)
